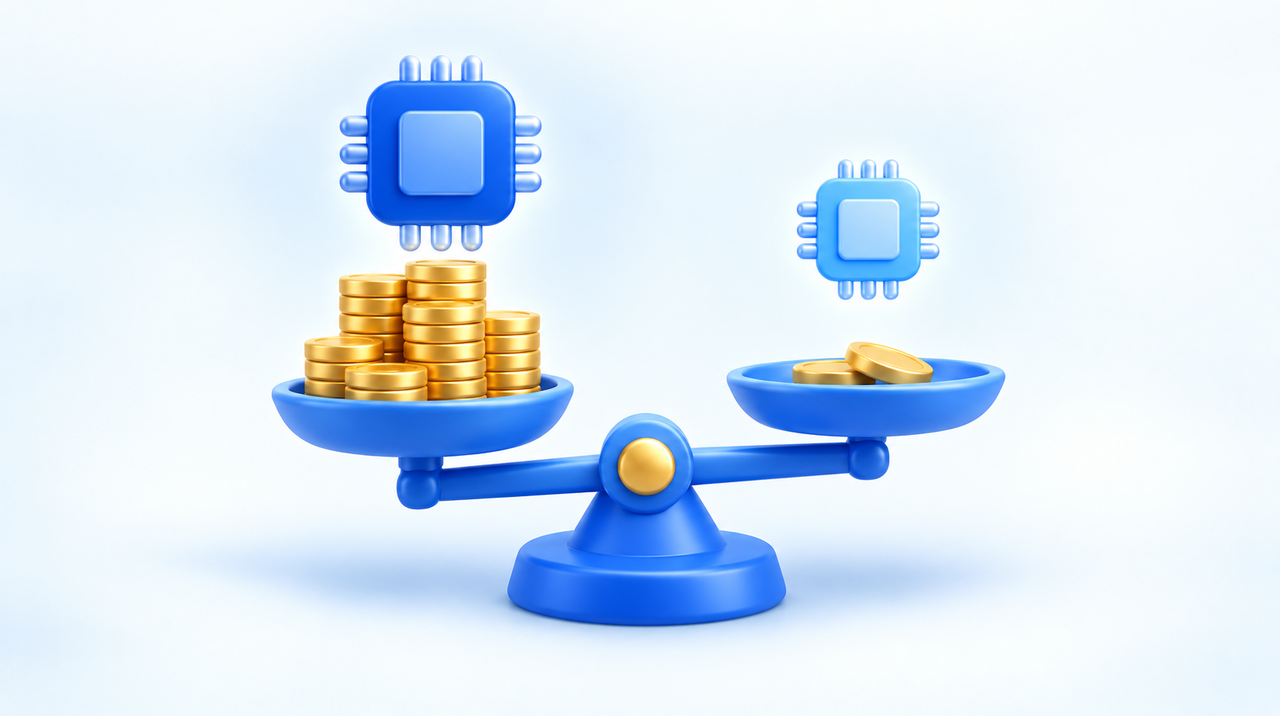
El 3 de septiembre OpenAI lanzó su modelo más caro. Siete días después, DeepSeek lanzó uno que cobra 67 veces menos y cuyos pesos cualquiera puede descargar gratis.
La lectura perezosa es "lo barato alcanzó a lo caro". No lo alcanzó, y los propios números muestran dónde no lo alcanzó. La lectura útil es otra: con esa distancia de precio, elegir un solo modelo para toda la empresa se volvió un desperdicio.
Los dos precios, uno al lado del otro
Valores por millón de tokens, que es la unidad de cobro. Un millón de tokens equivale a algo así como 700 mil palabras.
- GPT-6 Astra, lanzado el 3 de septiembre: US$ 10 de entrada y US$ 50 de salida. Entrada en caché a US$ 1, escritura de caché a US$ 12,50.
- DeepSeek V4.1 Flash, lanzado el 10 de septiembre: US$ 0,15 de entrada y US$ 0,60 de salida fuera de hora pico, entrada en caché a US$ 0,003. En horario pico, los valores se duplican.
Fuera de hora pico, la diferencia es de 67 veces en la entrada y 83 veces en la salida. En hora pico, baja a 33 y 42 veces. Sigue siendo otro orden de magnitud.
Y hay un detalle que cambia la conversación: los pesos de V4.1 Flash están en Hugging Face bajo licencia MIT, con uso comercial habilitado. Son 552 mil millones de parámetros en el tronco, de los cuales solo 8 mil millones entran en acción en la lectura y 16 mil millones en la escritura — por eso sale tan barato.
Dónde lo barato rinde bien, y quién lo está afirmando
DeepSeek publica victorias sobre los dos buques insignia estadounidenses: 74,2 contra 74,0 de Claude Opus 5 y 73,0 de GPT-5.6 Sol en una prueba de ingeniería de software; 88,1 en una prueba de seguridad; 54,8 en una de automatización.
La salvedad es grande y debe acompañar el dato: esas evaluaciones fueron ejecutadas por la propia DeepSeek y nadie las replicó de forma independiente. Un número del fabricante sobre su propio producto es un punto de partida, no una prueba. Sirve como indicio de que la diferencia se redujo, no como medida de cuánto.
Dónde lo caro todavía gana, y por amplio margen
En las pruebas donde los modelos estadounidenses lideran, la distancia no es de decimales.
- Terminal-Bench 3.0: 43,3 de Opus 5 contra 30,0.
- Terminal-Bench 4.0: 51,8 de Opus 5 contra 31,2.
- GPQA Diamond y SEC-Bench Pro: GPT-5.6 Sol lidera.
Esas pruebas miden tareas largas, con muchos pasos encadenados, donde equivocarse en el tercer paso arruina los otros diez. Es exactamente el tipo de trabajo en que pagar caro se justifica.
Cómo separar tu trabajo por nivel de exigencia
El criterio no es el tema, es el costo del error y el tamaño de la cadena. Cuatro categorías resuelven casi todo:
- Volumen alto, error barato, respuesta corta. Clasificar mensajes, resumir, extraer datos de un formulario, sugerir una respuesta que una persona revisa. Es el grueso del uso de una empresa pequeña, y es donde el modelo barato resuelve.
- Tarea larga, muchos pasos, error caro. Migrar un sistema, tocar código de producción, conciliar datos financieros. Modelo caro, y aun así con revisión humana.
- Texto que va al cliente con tu nombre. Se decide por la calidad percibida, no por el costo por token: el valor del token es irrelevante frente al costo de una respuesta errada firmada por tu empresa.
- Dato sensible. Esta categoría no se decide por ningún precio, y es el tema de la última sección.
En la práctica, la mayoría de las empresas descubre que el 80% del volumen está en la primera categoría y que venía pagando precio de cuarta categoría por todo.
La cuenta, con los números reales
Una automatización de tamaño medio que consume 50 millones de tokens de entrada y 10 millones de salida por mes:
- En el modelo caro: US$ 1.000 por mes.
- En el barato, fuera de hora pico: US$ 13,50 por mes.
Incluso un uso pequeño, de 2 millones de entrada y 400 mil de salida, sale por US$ 40 contra US$ 0,54. La diferencia rara vez es lo que decide en un uso pequeño; decide cuando quieres activar la automatización en todo en lugar de elegir dónde activarla, y es eso lo que el nuevo precio permite.
Antes de cambiar cualquier cosa, vale la pena releer lo que el caché hace con esta cuenta, tratado en precio de la IA: el descuento que pagas con tus datos — el descuento de caché solo vale si el comienzo del pedido es idéntico entre llamadas.
Lo que ningún precio resuelve
Los US$ 0,15 son el precio de la interfaz de DeepSeek. Usar esa interfaz es enviar tu texto a la empresa, con sus términos. Peso abierto es otra cosa: significa que puedes correr el modelo en tu propia infraestructura, sin mandar nada afuera — y ahí la cuenta deja de ser por token y pasa a ser de máquina, como hicimos en modelo de IA abierto y gratuito: cuánto cuesta correrlo en tu empresa.
La pregunta de quién procesa tu texto se volvió más importante, no menos, y está tratada en quién procesa de verdad el texto que le mandas a la IA. Un precio bajo no cambia ninguna cláusula del contrato ni la base legal del tratamiento de datos.
Armar esto separado por nivel de exigencia, con el modelo correcto en cada categoría, es lo que hacemos en implementación de IA para empresas.
Fuentes
Lanzamiento y tabla de precios de DeepSeek V4.1 Flash según la cobertura de VentureBeat del 10 de septiembre de 2026, de donde también provienen los valores de hora pico y fuera de hora pico, la licencia MIT de los pesos en Hugging Face, el conteo de parámetros y la observación de que las evaluaciones citadas fueron ejecutadas por la propia DeepSeek. Precios de GPT-6 Astra según la tabla pública de OpenAI, con lanzamiento el 3 de septiembre de 2026.
Preguntas frecuentes
¿Cuánto cuesta DeepSeek V4.1 Flash en comparación con GPT-6 Astra?
Por millón de tokens y en horario valle, V4.1 Flash cobra US$ 0,15 de entrada y US$ 0,60 de salida, con entrada en caché a US$ 0,003. GPT-6 Astra cobra US$ 10 de entrada y US$ 50 de salida, con entrada en caché a US$ 1. La diferencia en horario valle es de unas 67 veces en entrada y 83 veces en salida; en horario pico los valores de DeepSeek se duplican y la diferencia baja a 33 y 42 veces.
¿El modelo barato ya es tan bueno como el caro?
Depende de la tarea, y los datos disponibles no permiten afirmarlo. DeepSeek publica victorias ajustadas en pruebas de ingeniería de software, seguridad y automatización, pero esas evaluaciones las corrió la propia empresa y no hubo réplica independiente. En pruebas de tareas largas, como Terminal-Bench, los modelos estadounidenses lideran por un margen amplio: 51,8 contra 31,2 en la versión 4.0.
¿Cómo decidir qué modelo usar en cada caso?
Sepáralos por el costo del error y por el largo de la cadena de pasos, no por el tema. Volumen alto con error barato y respuesta corta —clasificar, resumir, extraer datos— va al modelo barato. Tarea larga con muchos pasos encadenados y error caro va al modelo caro, con revisión humana. El texto que sale firmado por la empresa se decide por calidad percibida. El dato sensible se decide por dónde se procesa, no por el precio.
¿Pesos abiertos significa que puedo usarlo gratis en mi empresa?
La licencia MIT permite uso comercial, modificación y redistribución, así que sí, puedes usar los pesos. Pero ejecutar el modelo exige infraestructura propia, y el costo pasa a ser de máquina, energía y operación en lugar de por token. Usar la interfaz paga de DeepSeek es más barato y más simple; ejecutarlo por cuenta propia resuelve el problema de a dónde va tu texto.
¿Usar un modelo chino es un problema de protección de datos?
El punto no es la nacionalidad, es a dónde va el dato y bajo qué términos. Al usar la interfaz de cualquier proveedor, tu texto es procesado por él. Si el dato es sensible, la decisión pasa por el contrato, por la base legal del tratamiento y por la posibilidad de ejecutar el modelo en tu propia infraestructura, algo que los pesos abiertos permiten.
¿Vale la pena cambiar de modelo ahora?
Vale la pena medir antes de cambiar. Toma un mes de uso real, revisa cuánto del volumen está en tareas simples y calcula la cuenta con los dos precios. En la mayoría de las empresas pequeñas, el grueso del volumen es tarea simple, y el ahorro aparece sin tocar las tareas críticas, que siguen en el modelo caro.